브랜드 블로그 대행 업체 추천을 받기 전에 먼저 정할 것은 글을 어디에 올리느냐예요. 2026년 9월 29일에 받은 robots.txt 원문을 보면 네이버 블로그(blog.naver.com)와 네이버 프리미엄콘텐츠(contents.premium.naver.com)는 챗GPT 검색 크롤러 OAI-SearchBot, OpenAI 학습 크롤러 GPTBot, 구글이 제미나이 학습 · 근거에 쓸지 정하는 표시 Google-Extended를 모두 「Disallow: /」로 막고 있어요. OpenAI 문서대로라면 여기 쓴 글은 챗GPT 검색 답변에 나오지 않아요. 회사 사이트 안 블로그는 이 규칙을 회사가 직접 정하고요.
저번 글에서 챗GPT에 회사가 나오는 길은 광고와 답변 속 추천, 두 가지이고 둘은 서로 다른 일이라고 했었죠. 아마 이 글을 찾으신 분들은 블로그를 꾸준히 올리면 AI 검색에도 우리 회사가 나올 거라 생각하고 대행 업체를 알아보고 계셨을 거예요. 근데 같은 글이라도 어디에 올리느냐에 따라 AI가 읽어 갈 수 있는지부터 달라져요.
그래서 딱 네 가지만 순서대로 정리해 볼게요. 대행 업체를 고를 때 무엇부터 보는지, 네이버 블로그와 프리미엄콘텐츠가 AI 크롤러를 막는지, 네이버 블로그 글은 구글 검색에 노출되는지, 기업 블로그는 어디에 두는지예요.
브랜드 블로그 대행 업체를 고를 때 무엇부터 확인하나요?
글을 올릴 주소와 그 주소의 robots.txt부터 확인하세요. robots.txt는 사이트 맨 위 폴더에 두는 파일로, 크롤러 이름마다 읽어 가도 되는지를 적어 둬요. AI 검색 크롤러를 막아 둔 주소에 올린 글은 그 AI의 답에 출처로 쓰이기 어려워요.
AI도 이 질문에 실제로 검색을 해요. 서드플랜이 2026년 9월 29일 새벽 Gemini API(gemini-3.8-flash · 구글 검색 연동)에 「브랜드 블로그 대행 업체 추천해줘」를 3번 물었더니 3번 다 구글 검색을 했어요. 나눠서 친 검색어는 「브랜드 블로그 대행 업체 잘하는곳 추천」, 「브랜드 블로그 대행 업체 비교」, 「브랜드 블로그 대행 업체 추천」, 「브랜드 블로그 마케팅 대행사 추천 네이버」였고요.
재미있는 건 출처예요. 같은 날 새벽 구글 검색(한국 · 데스크톱)에서 「브랜드 블로그 대행 업체 추천」의 자연 검색 상위 10개 가운데 5개가 네이버 블로그 글(blog.naver.com 4개 · m.blog.naver.com 1개)이었어요. 그런데 Gemini 답 3번에 출처로 붙은 사이트 13개(같은 사이트 중복 포함) 가운데 네이버 블로그 주소는 하나도 없었어요. youtube.com 1개를 빼면 12개가 모두 .com · .kr로 끝나는 개별 도메인이었죠(서드플랜 실측 · 3번 물어 본 값이라 경향으로만 봐요).
그래서 여러분이 업체를 고를 때는 이 세 가지만 물어보시면 돼요.
- 글을 올릴 주소 — 네이버 블로그인지, 네이버 프리미엄콘텐츠인지, 회사 사이트 안(회사 도메인)인지 물어요.
- 그 주소의 robots.txt — 주소 뒤에 /robots.txt를 붙여 열면 누구나 볼 수 있어요. OAI-SearchBot · Google-Extended 줄에 「Disallow: /」가 있는지 봐요.
- AI 답에서 다시 재는지 — 같은 질문을 AI에 여러 번 물어, 올린 글이 출처로 붙는지 달마다 세는지 물어요.
네이버 블로그와 프리미엄콘텐츠는 AI 크롤러를 막나요?
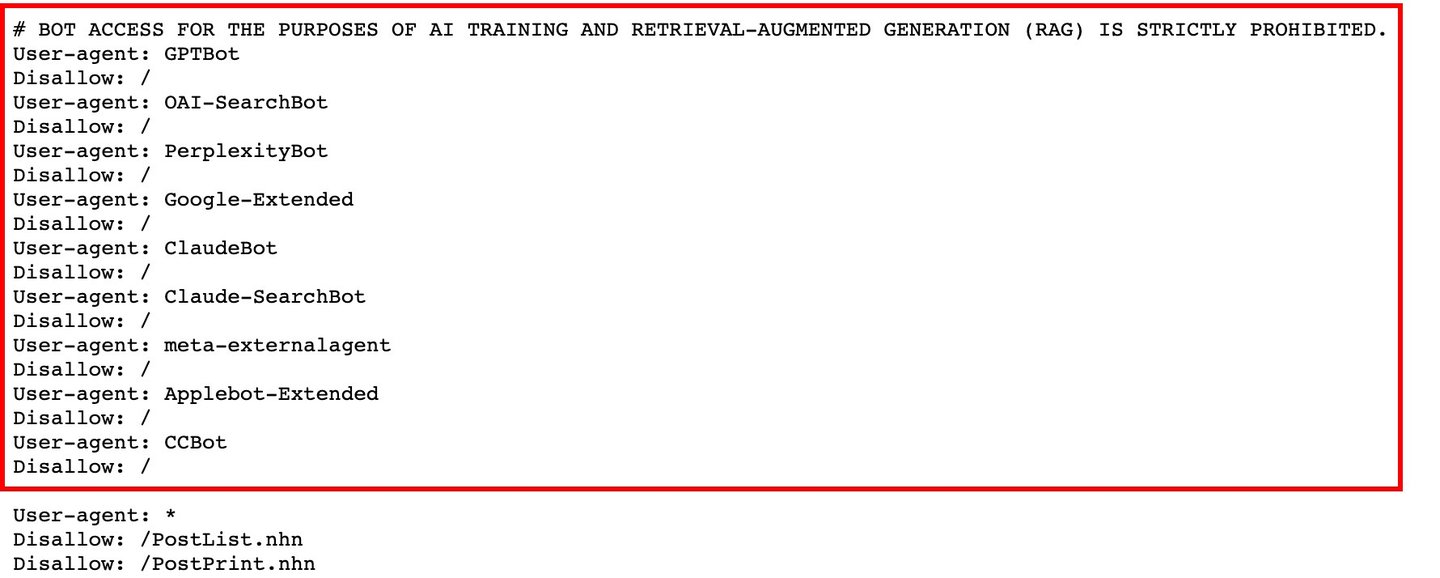
네, 막아요. 2026년 9월 29일 오전 10시 41분에 받은 두 곳의 robots.txt는 GPTBot · OAI-SearchBot · PerplexityBot · Google-Extended · ClaudeBot · Claude-SearchBot · meta-externalagent · Applebot-Extended · CCBot, 이렇게 아홉 개 이름에 모두 「Disallow: /」를 적어 두었어요. 블로그 모바일 주소(m.blog.naver.com)의 파일도 같고요.
두 파일 모두 그 위에 「# BOT ACCESS FOR THE PURPOSES OF AI TRAINING AND RETRIEVAL-AUGMENTED GENERATION (RAG) IS STRICTLY PROHIBITED.」라는 주석도 달려 있어요. AI 학습과 검색 증강 생성(RAG)을 위한 봇 접근을 엄격히 금지한다는 뜻이에요. 서버가 알려 준 파일 수정 시각은 blog.naver.com이 2025년 10월 21일, contents.premium.naver.com이 2026년 6월 23일이었어요.
| robots.txt의 이름 | 회사 문서가 적은 쓰임 | 네이버 블로그 | 네이버 프리미엄콘텐츠 | 서드플랜 사이트 |
|---|---|---|---|---|
| OAI-SearchBot | 챗GPT 검색 기능에 사이트를 보여 줌 · 막으면 챗GPT 검색 답변에 안 나옴(OpenAI) | Disallow: / | Disallow: / | Allow: / |
| GPTBot | OpenAI 생성형 AI 모델 학습에 쓸 수 있는 수집(OpenAI) | Disallow: / | Disallow: / | Allow: / |
| Google-Extended | 제미나이 모델 학습과 제미나이 앱 · Vertex AI 답의 근거(그라운딩)에 쓸지 정함 · 구글 검색 포함 여부와는 관계없음(구글) | Disallow: / | Disallow: / | Allow: / |
| PerplexityBot | 퍼플렉시티 검색 결과에 사이트를 보여 주고 링크함(퍼플렉시티) | Disallow: / | Disallow: / | Allow: / |
| Claude-SearchBot | 클로드 검색 답변을 위한 색인 · 막으면 검색 노출이 줄 수 있음(앤트로픽) | Disallow: / | Disallow: / | Allow: / |
| Googlebot | 구글 검색 · AI 개요 · AI 모드(구글) | 따로 적은 줄 없음 → User-agent: * 줄을 따름(글 주소는 막지 않음) | 따로 적은 줄 없음 → User-agent: * 줄을 따름(글 주소는 막지 않음) | User-agent: * 줄 Allow: / |
표의 줄은 2026년 9월 29일에 받은 원문 그대로예요(서드플랜 사이트는 /api/ 주소만 Disallow). 원문은 blog.naver.com/robots.txt · contents.premium.naver.com/robots.txt · 3rdplan.com/robots.txt에서 누구나 열어 볼 수 있고, 파일은 운영하는 회사가 언제든 고칠 수 있어요.
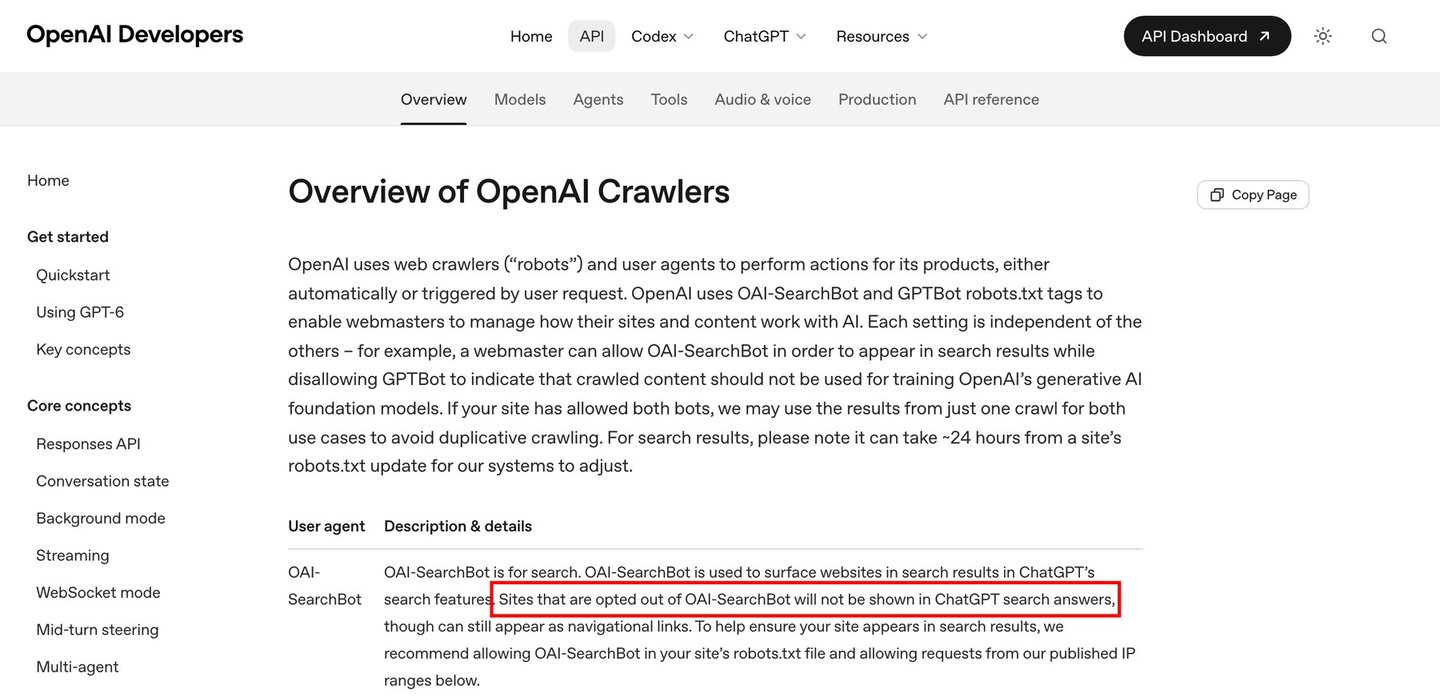
막았을 때 무슨 일이 생기는지는 각 회사 문서에 적혀 있어요. OpenAI는 OAI-SearchBot을 막은 사이트는 챗GPT 검색 답변에 나오지 않는다고 적어 놨어요. 탐색용 링크로는 나올 수 있고요.
OAI-SearchBot is for search. OAI-SearchBot is used to surface websites in search results in ChatGPT’s search features. Sites that are opted out of OAI-SearchBot will not be shown in ChatGPT search answers, though can still appear as navigational links.OAI-SearchBot은 검색용입니다. OAI-SearchBot은 챗GPT 검색 기능의 검색 결과에 웹사이트를 보여 주는 데 쓰입니다. OAI-SearchBot을 거부한 사이트는 챗GPT 검색 답변에 표시되지 않지만, 탐색용 링크로는 나타날 수 있습니다.
구글은 Google-Extended로 제미나이 모델 학습과, 제미나이 앱 · Vertex AI가 답을 만들 때 구글 검색 색인의 콘텐츠를 근거(그라운딩)로 쓸지를 정한다고 적고 있어요. 구글 검색에 사이트가 들어가는지와는 관계가 없다는 문장도 같이 있고요.
Google-Extended is a standalone product token that web publishers can use to manage whether content Google crawls from their sites may be used for training future generations of Gemini models that power Gemini Apps and Vertex AI API for Gemini and for grounding (providing content from the Google Search index to the model at prompt time to improve factuality and relevancy) in Gemini Apps and Grounding with Google Search on Vertex AI. Google-Extended does not impact a site's inclusion in Google Search nor is it used as a ranking signal in Google Search.Google-Extended는 독립형 제품 토큰으로서, 웹 게시자는 이를 사용해 Google이 사이트에서 크롤링하는 콘텐츠를 Gemini 앱 및 Gemini용 Vertex AI API를 지원하는 차세대 Gemini 모델을 학습시키는 데 사용하거나, Gemini 앱 및 Vertex AI에서 Google 검색을 사용한 그라운딩에서 그라운딩(프롬프트 시 사실성 및 관련성 개선을 위해 Google 검색 색인의 콘텐츠를 모델에 제공하는 것)에 사용할 수 있는지 여부를 관리할 수 있습니다. Google-Extended는 Google 검색에 사이트가 포함될지 여부에 영향을 미치지 않으며 Google 검색에서 순위 결정 신호로 사용되지도 않습니다.
근데 우리 블로그인데 이 줄을 우리가 바꿀 수는 없냐고요? 못 바꿔요. 구글의 robots.txt 규격 문서에 따르면 robots.txt는 사이트 맨 위 폴더에 두고, 그 규칙은 파일이 있는 호스트에만 적용돼요. blog.naver.com의 파일은 네이버가 운영하는 blog.naver.com 맨 위 폴더에 있고요.
이런 비유를 해 볼게요. 백화점 푸드코트에 가게를 냈다고 해 볼게요. 맛집 잡지 기자가 취재를 왔는데, 푸드코트 입구에 관리실이 써 둔 안내문이 있어요. 「○○ 잡지 · △△ 방송 취재 사절」. 가게 주인이 아무리 소개되고 싶어도 그 기자는 가게까지 못 들어와요. 그 잡지를 보고 맛집을 고르는 사람한테 이 가게는 없는 가게가 되는 거죠. 길가에 따로 가게를 낸 주인은요? 누구를 들일지 주인이 정하고요.
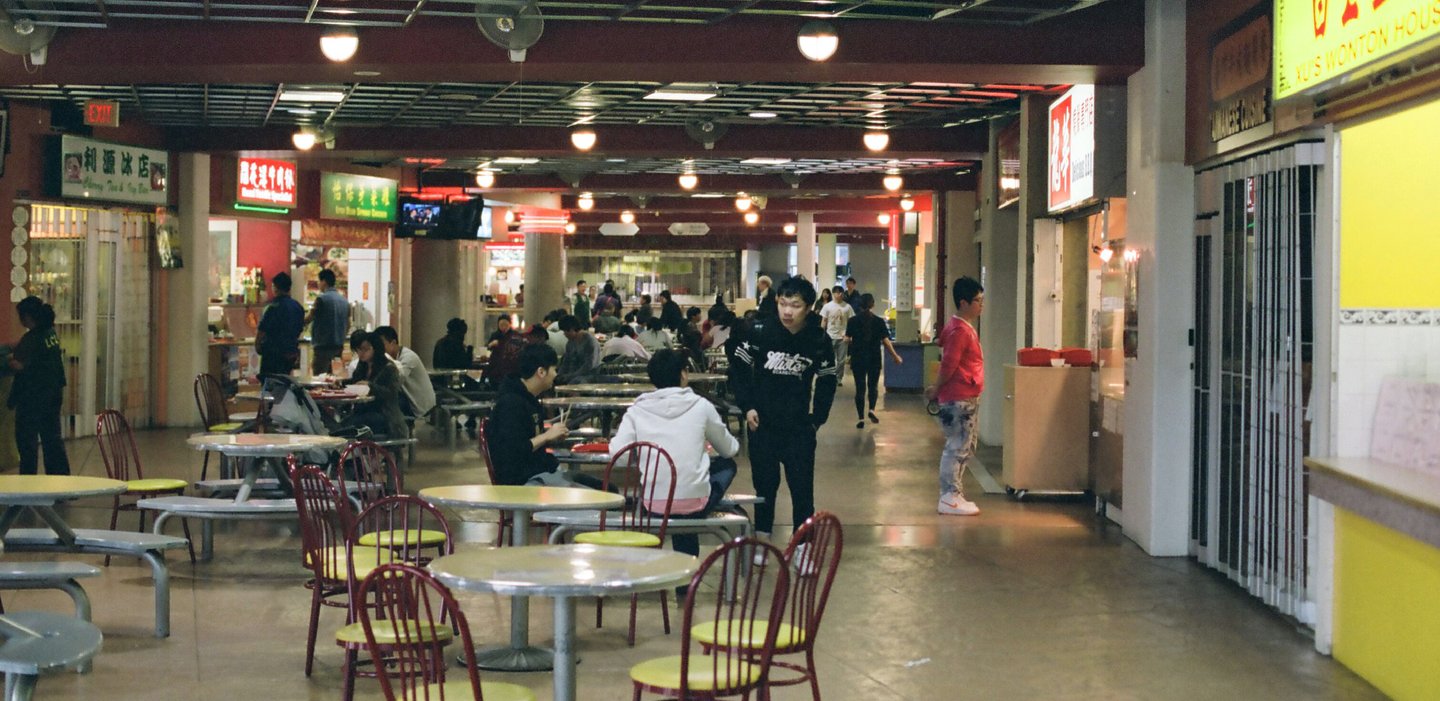
네이버 블로그에 쓴 글이 딱 그 푸드코트 안 가게예요. robots.txt가 관리실 안내문이고, 안내문에 적힌 매체 이름이 OAI-SearchBot · Google-Extended 같은 크롤러 이름이에요. 글쓴이가 아무리 AI 답에 소개되고 싶어도 네이버가 적어 둔 이 파일은 글쓴이가 고칠 수 없어요. 이해되시죠?
네이버 블로그 글은 구글 검색에 노출되나요?
네, 노출될 수 있어요. blog.naver.com의 robots.txt에는 구글 검색 크롤러 Googlebot만 따로 적은 줄이 없어서, Googlebot은 모든 크롤러에 쓰는 「User-agent: *」 줄을 따르는데 이 줄은 글 주소를 막지 않거든요.
Only one group is valid for a particular crawler. Google's crawlers determine the correct group of rules by finding in the robots.txt file the group with the most specific user agent that matches the crawler's user agent. Other groups are ignored.특정 크롤러에 하나의 그룹만 유효합니다. Google 크롤러는 robots.txt 파일에서 크롤러의 사용자 에이전트와 일치하는 가장 구체적인 사용자 에이전트가 있는 그룹을 찾아서 올바른 규칙 그룹을 결정합니다. 다른 그룹은 무시됩니다.
구글 AI 개요와 AI 모드도 같은 Googlebot 규칙을 따라요. 구글은 AI가 검색에 들어가 있어서 Googlebot의 robots.txt 지침으로 검색 크롤링을 관리하고, Google-Extended는 구글의 다른 시스템에서 AI 학습과 그라운딩을 제한할 때 쓴다고 적고 있어요.
AI is built into Search and integral to how Search functions, which is why robots.txt directives for Googlebot is the control for site owners to manage access to how their sites are crawled for Search. … To limit AI training and grounding in some of Google's other systems, read more about Google-Extended.AI는 검색에 내장되어 있으며 검색의 작동 방식에서 필수적인 역할을 합니다. 사이트 소유자는 Googlebot의 robots.txt 지침을 사용해 Google 검색에서 사이트가 크롤링되는 방식에 대한 액세스를 관리할 수 있습니다. … Google의 다른 시스템에서 AI 학습 및 그라운딩을 제한하려면 Google-Extended에 관해 자세히 알아보세요.
앞에서 본 구글 검색 상위 10개 가운데 5개가 네이버 블로그 글이었던 것도 Googlebot이 막혀 있지 않아서 가능한 일이죠. 그러니까 네이버 블로그 글은 구글 검색에는 나올 수 있고, 챗GPT 검색 답변과 제미나이 앱 답의 근거로는 쓰지 말라고 적혀 있는 셈이에요. 구글이 Google-Extended 문서에서 이름을 든 곳은 제미나이 앱과 Vertex AI라서, 저희가 잰 Gemini API 답에서 네이버 블로그 주소가 빠진 게 이 줄 때문인지는 확인하지 못했어요.
기업 블로그는 네이버 블로그와 회사 사이트 중 어디에 두나요?
AI 검색에서 찾게 하려면 회사 사이트 안에 두는 편이 맞아요. 회사 사이트는 robots.txt를 회사가 정하니까 OAI-SearchBot · Google-Extended 같은 AI 크롤러를 허용해 둘 수 있거든요. 네이버 안에서 찾는 손님을 노린 네이버 블로그 운영은 따로 판단할 일이고요.
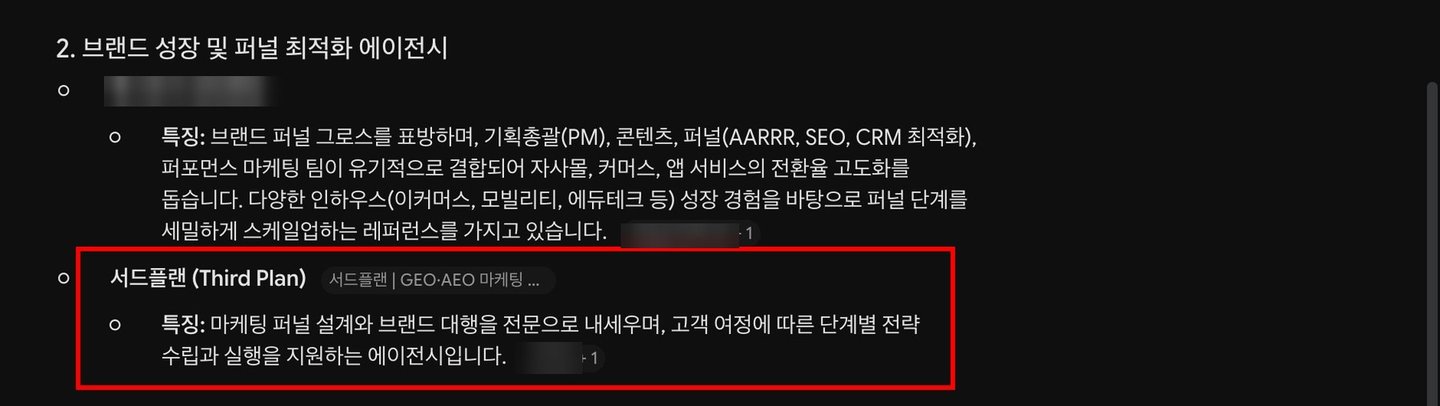
저희 사이트가 예예요. 지금 읽고 계신 이 칼럼도 회사 사이트(3rdplan.com) 안에 있어요. 3rdplan.com의 robots.txt는 OAI-SearchBot · GPTBot · Google-Extended · PerplexityBot · Claude-SearchBot을 포함해 이름을 적은 크롤러 여덟 개에 모두 「Allow: /」를 적어 두었어요. 그리고 서드플랜이 2026년 9월 28일 Gemini 앱에 「마케팅 퍼널 설계해주는 대행사 추천해줘」를 계정을 바꿔 가며 9번 물었을 때 6번 서드플랜 이름이 나왔고, 6번 모두 출처로 붙은 건 회사 사이트 안 페이지(3rdplan.com/funnel/)였어요(서드플랜 실측).
근데 회사 사이트라고 저절로 AI 크롤러가 허용되는 건 아니에요. 구글은 robots.txt뿐 아니라 CDN이나 호스팅 설정에서도 크롤링이 허용돼 있는지 확인하라고 적고 있어요. OpenAI도 robots.txt를 바꾼 뒤 검색 쪽에 반영되기까지 24시간쯤 걸릴 수 있다고 적어 놨고요. 그래서 파일을 고친 뒤에는 방화벽 설정까지 같이 보고, 하루쯤 지나 다시 확인해요.
서드플랜은 네이버 블로그를 대신 운영하지 않아요. 서드플랜의 GEO·AEO 대행은 회사 사이트의 자기소개를 정비하고, 영어 페이지를 만들고, 회사 사이트 안에 검색어 묶음별 글을 쓰고, 매달 같은 질문으로 다시 재는 일이에요. robots.txt에서 AI 크롤러를 막고 있는지는 GEO 컨설팅 진단 항목 여덟 가지 가운데 하나로 재고요.
브랜드 블로그 대행 전에 확인할 것 정리
자, 정리해 볼게요.
- 브랜드 블로그 대행을 맡기기 전에 글을 올릴 주소와 그 주소의 robots.txt부터 확인해요.
- 2026년 9월 29일 기준 네이버 블로그 · 프리미엄콘텐츠는 OAI-SearchBot · Google-Extended를 포함한 AI 크롤러 아홉 개를 막고 있어요. 푸드코트 안 가게처럼 이 규칙은 글쓴이가 바꿀 수 없어요.
- 네이버 블로그 글도 구글 검색에는 나올 수 있어요. AI 검색에서 찾게 하려면 규칙을 회사가 정하는 회사 사이트 안에 글을 둬요.
다음 내용은 다음 글에서 확인하겠습니다. AI 검색에 회사 이름이 안 나오는 곳 네 군데를 하나씩 짚어 볼 거예요. 오늘 본 AI 크롤러 허용도 그 네 군데 가운데 하나예요.
출처
- 네이버 블로그 robots.txt 원문 · 받은 날 2026-09-29 10:41 KST · 서버 표기 최종 수정 2025-10-21 11:29:58 GMT · blog.naver.com/
robots.txt - 네이버 블로그 모바일 robots.txt 원문 · 받은 날 2026-09-29 10:41 KST · m.blog.naver.com/
robots.txt - 네이버 프리미엄콘텐츠 robots.txt 원문 · 받은 날 2026-09-29 10:41 KST · 서버 표기 최종 수정 2026-06-23 06:13:14 GMT · contents.premium.naver.com/
robots.txt - 서드플랜 robots.txt 원문 · 받은 날 2026-09-29 10:41 KST · 서버 표기 최종 수정 2026-09-28 18:09:54 GMT · 3rdplan.com/
robots.txt - OpenAI 개발자 문서 「Overview of OpenAI Crawlers」 · 게시일 표기 없음 · 확인 2026-09-29 · developers.openai.com/
api/ docs/ bots - Google 크롤링 인프라 문서 「List of Google's common crawlers」(Google-Extended 절) · 최종 수정 2026-07-14(한국어판 2026-09-16) · 확인 2026-09-29 · developers.google.com/
crawling/ docs/ crawlers-fetchers/ google-common-crawlers - Google 크롤링 인프라 문서 「How Google interprets the robots.txt specification」 · 최종 수정 2026-08-31(한국어판 2026-09-11) · 확인 2026-09-29 · developers.google.com/
crawling/ docs/ robots-txt/ robots-txt-spec - Google 검색 센터 「AI features and your website」 · 최종 수정 2025-12-10(한국어판 2025-12-31) · 확인 2026-09-29 · developers.google.com/
search/ docs/ appearance/ ai-features - Perplexity 문서 「Perplexity Crawlers」 · 게시일 표기 없음 · 확인 2026-09-29 · docs.perplexity.ai/
docs/ resources/ perplexity-crawlers - Anthropic 도움말 「Does Anthropic crawl data from the web, and how can site owners block the crawler?」 · 페이지 표기 갱신 2026-04-07 · 확인 2026-09-29 · support.claude.com/
en/ articles/ 8896518-does-anthropic-crawl-data-from-the-web-and-how-can-site-owners-block-the-crawler - 플리커 사진 「Crystal Mall Food Court」(Chris Clogg · CC0 1.0) · 촬영 2014-04-17 · 라이선스 확인 2026-09-29 · www.flickr.com/
photos/ 46244586@N02/ 13893810912